Вы делаете семь порций одного и того же кофе латте. Каждый из них немного отличается: незначительное изменение ракурса, небольшой сдвиг освещения, ваша рука переместилась на 2 сантиметра. С точки зрения криптографической хэш-функции (MD5, SHA-256) эти семь фотографий полностью уникальны — ни один бит не совпадает. Для человеческого глаза они по сути идентичны.
Этот разрыв между уникальностью на машинном уровне и сходством, воспринимаемым человеком, является фундаментальной проблемой, которую решает перцептивное хеширование. Это основная технология, лежащая в основе любого современного средства для очистки дубликатов фотографий, и понимание того, как она работает, позволяет понять, почему некоторые средства для очистки значительно более точны, чем другие.
5 уровней обнаружения сходства фотографий
Сходство фотографий проявляется в широком спектре. Современные системы обнаружения одновременно используют несколько методов, каждый из которых оптимизирован для своего уровня:
| Уровень | Метод обнаружения | Что он ловит | Скорость | Точность |
|---|---|---|---|---|
| 1. Байт-идентично | Криптографический хэш (MD5/SHA-256) | Точные копии файлов, дубликаты AirDrop | Самый быстрый | 100 % (но узко) |
| 2. Пиксельно идентичен | Средний хэш (aHash) | Пересохраненные или перекодированные версии того же изображения | Очень быстро | 85% |
| 3. Визуально похоже | Перцепционный хэш (pHash/dHash) | Обрезанные, отфильтрованные или слегка повернутые версии | Быстро | 92% |
| 4. Семантически похоже | Нейронные внедрения (CNN/Vision Transformer) | Одна и та же сцена с разных ракурсов, серийная съемка | Умеренный | 97% |
| 5. Концептуально связано | Мультимодальные модели в стиле CLIP | Разные фотографии одного и того же объекта или темы | Медленно | Зависит от контекста |
Почему контрольные суммы MD5 пропускают 80 % визуальных дубликатов
Криптографические хеши, такие как MD5 и SHA-256, были разработаны для проверки целостности данных, а не визуального сходства. Они создают дайджест фиксированной длины, в котором изменение одного бита во входных данных приводит к совершенно другому хешу. Это означает:
- Пересохранение JPEG с другим уровнем качества → совершенно новый хеш
- Преобразование HEIC в JPEG → совершенно новый хеш
- Обрезка 2 пикселей от края → совершенно новый хэш
- Добавление фильтра Instagram → совершенно новый хеш
- Скриншоты той же фотографии → совершенно новый хеш
В реальных фотосъемках только около 15–20 % дубликатов представляют собой точные копии на уровне байтов (обычно в результате передачи через AirDrop или ошибок облачной синхронизации). Остальные 80 % — это визуальные дубликаты, требующие перцептивного анализа.
Как работает перцептивное хеширование (pHash и dHash)
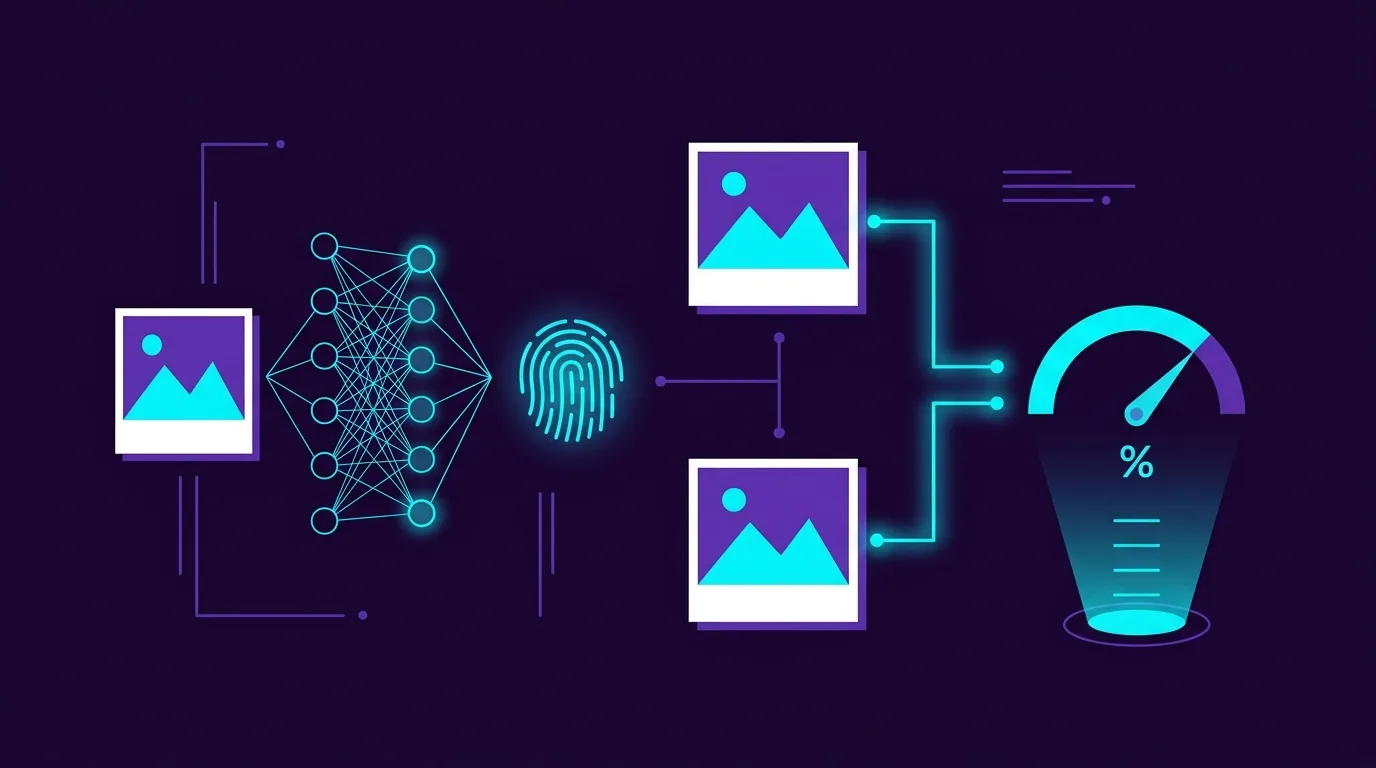
Перцептивное хеширование создает компактный отпечаток, который фиксирует визуальную структуру изображения, а не его необработанное байтовое содержимое. Алгоритм следует общему конвейеру:
- Изменить размер до мелкой сетки. Изображение уменьшается до небольшого разрешения (обычно 8 × 8 или 32 × 32 пикселя), уничтожая мелкие детали, но сохраняя общую структуру яркости.
- Преобразовать в оттенки серого. Информация о цвете удаляется. Перцептивное сходство заключается в первую очередь в структуре, а не в оттенке: фотография с теплым фильтром и фотография с холодным фильтром все равно должны совпадать.
- Вычислить градиент или среднее значение. Для dHash (разностный хеш) каждый пиксель сравнивается со своим правым соседом. Для aHash (средний хэш) каждый пиксель сравнивается со средней яркостью сетки. Каждое сравнение дает один бит: ярче = 1, темнее = 0.
- Создание двоичного отпечатка пальца: Результатом является 64-битная (8×8) или 1024-битная (32×32) двоичная строка — перцептуальный хэш.
- Сравнение с использованием расстояния Хэмминга. Два изображения сравниваются путем подсчета разницы в битах между их хэшами. Расстояние Хэмминга 0 = идентичная структура. Расстояние ≤ 5 (из 64) = визуально почти идентично. Расстояние ≤ 10 = вероятно, похоже.
Почему pHash работает с отфильтрованными фотографиями
Поскольку алгоритм отбрасывает цвет и мелкие детали на шагах 1–2, версия фотографии, отфильтрованная Instagram, создает почти такой же хэш восприятия, что и оригинал. Крупномасштабная структура яркости — яркое небо вверху и темная земля внизу — остается одинаковой независимо от цветокоррекции.
SSIM: измерение того, что на самом деле видит человеческий глаз
Индекс структурного сходства (SSIM), разработанный Wang et al. в 2004 году выходит за рамки двоичного хеширования. Он вычисляет непрерывную оценку сходства (от 0,0 до 1,0) на основе трех компонентов, которые отражают визуальное восприятие человека:
- Сравнение яркости: Сходны ли средние уровни яркости? (Компенсирует разницу в экспозиции)
- Сравнение контрастности: имеют ли изображения одинаковый динамический диапазон?
- Сравнение структуры: совпадают ли пространственные закономерности светлых и темных областей?
Показатель SSIM выше 0,92 обычно означает, что два изображения практически неразличимы для большинства зрителей. Современные средства очистки фотографий используют этот порог, чтобы автоматически отмечать почти дубликаты, сохраняя при этом действительно разные композиции.
Нейронные внедрения: рубеж глубокого обучения
Перцептуальное хэширование сталкивается с семантическим сходством — фотографии одной и той же сцены, снятые с разных позиций, или серийные эпизоды, в которых объект значительно перемещается между кадрами. В этих случаях нейронные сети на устройстве (сверточные модели или модели Vision Transformer) извлекают многомерные векторы внедрения.
Вот как это работает: нейронная сеть обрабатывает каждую фотографию и выдает 512-мерный вектор с плавающей запятой — по сути, 512 чисел, которые кодируют смысловое содержание изображения. Фотографии одного и того же заката, снятые с разницей в несколько секунд и снятые под разными углами, создают встраивание векторов, геометрически близких в этом 512-мерном пространстве.
Затем сходство измеряется с использованием косинусного сходства: косинуса угла между двумя векторами. Косинусное сходство 1,0 = идентичное семантическое содержание. Порог 0,85+ улавливает пакетные последовательности, почти идентичные композиции и тонкие вариации, которые невозможно пропустить при помощи перцептивного хеширования.
Обработка на устройстве или в облаке: аспект конфиденциальности
Запуск моделей внедрения нейронных сетей требует значительных вычислительных мощностей. Некоторые приложения для очистки фотографий загружают ваши изображения в облачные графические процессоры для анализа, что представляет собой серьезную угрозу конфиденциальности. Современные устройства Apple включают Neural Engine (16-ядерный на A17 Pro, 5 TOPS на серии M), способный запускать модели машинного зрения CoreML полностью на устройстве. Это означает, что 512-мерные вложения можно вычислить для 10 000 фотографий менее чем за 3 минуты, при этом данные не покидают устройство.
| Подход к обработке | Скорость (10 тыс. фотографий) | Конфиденциальность | Точность |
|---|---|---|---|
| Облачный графический процессор (NVIDIA A100) | 30 секунд | Фотографии, загруженные на внешние серверы | Самый высокий (самые большие модели) |
| Нейронный механизм на устройстве | 2–4 минуты | 100 % локально, отсутствие передачи по сети | Отлично (оптимизированные модели CoreML) |
| Только процессор устройства | 15–25 минут | 100 % локальный | Хорошо (ограниченная сложность модели) |
Увидеть нейронное обнаружение дубликатов в действии
Swipe Photo Cleaner (Wipe AI) сочетает в себе перцепционное хеширование для быстрой первоначальной фильтрации и встроенные нейронные возможности CoreML на устройстве для глубокой семантической группировки. Результат: серийные последовательности, отфильтрованные копии и почти идентичные композиции автоматически группируются с выделением самой четкой фотографии — все это обрабатывается локально на Neural Engine вашего устройства без загрузки ни одного байта в облако.
Калькулятор Памяти iPhone & Экономии на iCloud
Оцените объем свободной памяти и сумму, которую можно сэкономить на подписке iCloud