같은 커피 라떼를 7잔 마십니다. 각각은 약간씩 다릅니다. 약간의 각도 변화, 작은 조명 변화, 손이 2센티미터 움직였습니다. 암호화 해시 함수(MD5, SHA-256)의 경우 이 7장의 사진은 완전히 고유하며 단 한 비트도 일치하지 않습니다. 사람의 눈으로 보기에는 본질적으로 동일합니다.
기계 수준의 고유성과 인간이 인지하는 유사성 간의 이러한 격차는 지각 해싱이 해결하는 근본적인 문제입니다. 이는 모든 최신 복제 사진 클리너의 핵심 기술이며, 작동 방식을 이해하면 일부 클리너가 다른 클리너보다 훨씬 더 정확한 이유를 알 수 있습니다.
5단계 사진 유사성 감지
사진 유사성은 스펙트럼에서 작동합니다. 최신 탐지 시스템은 여러 기술을 동시에 사용하며 각각은 서로 다른 수준에 최적화되어 있습니다.
| 레벨 | 감지 방법 | 잡는 것 | 속도 | 정확성 |
|---|---|---|---|---|
| 1. 바이트 동일 | 암호화 해시(MD5/SHA-256) | 정확한 파일 사본, AirDrop 중복 | 가장 빠름 | 100%(단, 좁음) |
| 2. 픽셀 동일 | 평균 해시(aHash) | 동일 이미지의 다시 저장되거나 다시 인코딩된 버전 | 매우 빠릅니다 | 85% |
| 3. 시각적으로 유사 | 지각적 해시(pHash/dHash) | 잘림, 필터링 또는 약간 회전된 버전 | 빠름 | 92% |
| 4. 의미상 유사 | 신경 임베딩(CNN/Vision Transformer) | 다른 각도에서 본 같은 장면, 버스트 시퀀스 | 보통 | 97% |
| 5. 개념적으로 관련됨 | CLIP 스타일 다중 모드 모델 | 동일한 주제나 테마의 다른 사진 | 느림 | 상황에 따라 다름 |
MD5 체크섬이 시각적 중복 항목의 80%를 놓치는 이유
MD5 및 SHA-256과 같은 암호화 해시는 시각적 유사성이 아닌 데이터 무결성 확인을 위해 설계되었습니다. 입력에서 단일 비트를 변경하면 완전히 다른 해시가 생성되는 고정 길이 다이제스트를 생성합니다. 이는 다음을 의미합니다:
- 다른 품질 수준으로 JPEG 다시 저장 → 완전히 새로운 해시
- HEIC를 JPEG로 변환 → 완전히 새로운 해시
- 가장자리에서 2픽셀 자르기 → 완전히 새로운 해시
- 인스타그램 필터 추가 → 완전히 새로운 해시
- 같은 사진의 스크린샷 → 완전히 새로운 해시
실제 카메라 롤에서 중복 항목의 약 15~20%만이 정확한 바이트 수준 복사본입니다(일반적으로 AirDrop 전송 또는 클라우드 동기화 오류로 인해 발생). 나머지 80%는 지각 분석이 필요한 시각적 중복입니다.
지각 해싱 작동 방식(pHash 및 dHash)
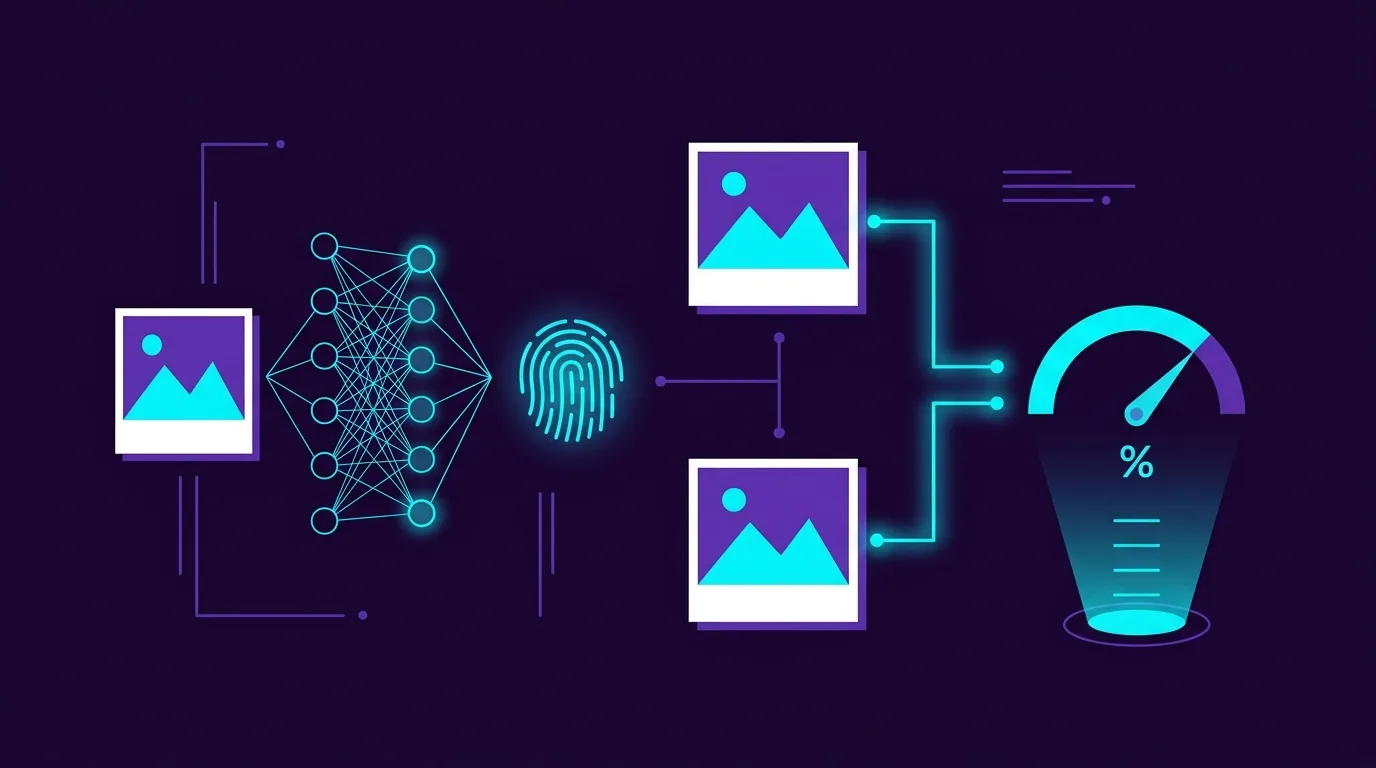
지각적 해싱은 원시 바이트 콘텐츠가 아닌 이미지의 시각적 구조를 캡처하는 압축 지문을 생성합니다. 알고리즘은 일반적인 파이프라인을 따릅니다:
- 작은 격자로 크기 조정: 이미지가 작은 해상도(일반적으로 8×8 또는 32×32 픽셀)로 축소되어 미세한 세부 묘사가 파괴되지만 전체적인 휘도 구조는 보존됩니다.
- 회색조로 변환: 색상 정보가 삭제됩니다. 지각적 유사성은 주로 색조가 아닌 구조에 관한 것입니다. 따뜻한 필터를 사용한 사진과 차가운 필터를 사용한 사진은 여전히 일치해야 합니다.
- 경도 또는 평균 계산: dHash(차이 해시)의 경우 각 픽셀이 오른쪽 이웃과 비교됩니다. aHash(평균 해시)의 경우 각 픽셀은 그리드의 평균 휘도와 비교됩니다. 각 비교는 단일 비트를 생성합니다: 더 밝음 = 1, 더 어두움 = 0.
- 바이너리 지문 생성: 결과는 64비트(8×8) 또는 1024비트(32×32) 바이너리 문자열인 지각 해시입니다.
- 해밍 거리를 사용하여 비교: 해시 간 비트 차이를 계산하여 두 이미지를 비교합니다. 해밍 거리 0 = 동일한 구조. 거리 ≤ 5(64개 중) = 시각적으로 거의 동일합니다. 거리 ≤ 10 = 아마도 비슷할 것입니다.
필터링된 사진에서 pHash가 작동하는 이유
알고리즘은 1~2단계에서 색상과 미세한 세부 묘사를 삭제하기 때문에 Instagram으로 필터링된 사진 버전은 원본과 거의 동일한 인식 해시를 생성합니다. 상단의 밝은 하늘, 하단의 어두운 바닥 등 대규모 휘도 구조는 컬러 그레이딩에 관계없이 동일하게 유지됩니다.
SSIM: 인간의 눈이 실제로 보는 것을 측정
Wang 외 연구진이 개발한 구조적 유사성 지수(SSIM) 2004년에는 바이너리 해싱을 넘어섰습니다. 인간의 시각적 인식을 반영하는 세 가지 구성 요소를 기반으로 지속적인 유사성 점수(0.0~1.0)를 계산합니다.
- 휘도 비교: 평균 밝기 수준이 비슷합니까? (노출 차이를 보정합니다)
- 대비 비교: 이미지의 동적 범위가 비슷합니까?
- 구조 비교: 밝은 영역과 어두운 영역의 공간 패턴이 일치합니까?
SSIM 점수가 0.92 이상인 경우 일반적으로 대부분의 시청자가 두 이미지를 지각적으로 구별할 수 없음을 나타냅니다. 최신 사진 정리 도구는 이 임계값을 사용하여 완전히 다른 구성을 유지하면서 거의 중복된 항목을 자동으로 표시합니다.
신경 임베딩: 딥 러닝 개척
지각적 해싱은 의미적 유사성으로 인해 어려움을 겪습니다. 동일한 장면을 다른 위치에서 찍은 사진이거나 피사체가 프레임 간에 크게 이동한 버스트 시퀀스입니다. 이러한 경우 기기 내 신경망(컨벌루션 또는 Vision Transformer 모델)은 고차원 임베딩 벡터를 추출합니다.
작동 방식은 다음과 같습니다. 신경망이 각 사진을 처리하고 512차원 부동 소수점 벡터(기본적으로 이미지의 의미 콘텐츠를 인코딩하는 512개의 숫자)를 출력합니다. 서로 다른 각도에서 몇 초 간격으로 촬영한 동일한 일몰 사진은 이 512차원 공간에서 기하학적으로 가까운 임베딩 벡터를 생성합니다.
유사성은 코사인 유사성, 즉 두 벡터 사이의 각도의 코사인을 사용하여 측정됩니다. 1.0의 코사인 유사성 = 동일한 의미론적 내용. 0.85+의 임계값은 지각 해싱만으로는 놓칠 수 있는 버스트 시퀀스, 거의 동일한 구성 및 미묘한 변형을 포착합니다.
기기 내 처리와 클라우드 처리: 개인 정보 보호 차원
신경 임베딩 모델을 실행하려면 상당한 컴퓨팅 성능이 필요합니다. 일부 사진 정리 앱은 분석을 위해 이미지를 클라우드 GPU에 업로드하므로 엄청난 개인 정보 보호 위험이 있습니다. 최신 Apple 기기에는 CoreML 비전 모델을 기기 전체에서 실행할 수 있는 Neural Engine(A17 Pro의 경우 16코어, M 시리즈의 경우 5TOPS)이 포함되어 있습니다. 이는 데이터가 기기 외부로 나가지 않고도 3분 이내에 10,000장의 사진에 대해 512차원 임베딩을 계산할 수 있음을 의미합니다.
| 처리 접근 방식 | 속도(사진 10K) | 개인정보 | 정확성 |
|---|---|---|---|
| 클라우드 GPU(NVIDIA A100) | 30초 | 외부 서버에 업로드된 사진 | 가장 높음(가장 큰 모델) |
| 기기 내 신경 엔진 | 2~4분 | 100% 로컬, 네트워크 전송 없음 | 우수함(최적화된 CoreML 모델) |
| 기기 내 CPU만 해당 | 15~25분 | 100% 현지 | 양호(모델 복잡도 제한) |
신경 중복 감지 실제 작동 보기
Swipe Photo Cleaner(Wipe AI)는 빠른 초기 필터링을 위한 지각 해싱과 심층적인 의미 그룹화를 위한 기기 내 CoreML 신경 임베딩을 결합합니다. 결과: 버스트 시퀀스, 필터링된 사본 및 거의 동일한 구성이 가장 선명한 사진이 강조 표시된 상태로 자동으로 클러스터링되며, 모두 클라우드에 단일 바이트를 업로드하지 않고도 장치의 Neural Engine에서 로컬로 처리됩니다.