Fai sette bicchierini dello stesso caffè latte. Ognuno è leggermente diverso: un piccolo cambiamento di angolazione, un piccolo spostamento di illuminazione, la tua mano si è spostata di 2 centimetri. Secondo una funzione di hash crittografico (MD5, SHA-256), queste sette foto sono completamente uniche: non corrisponde un solo bit. Per un occhio umano sono essenzialmente identici.
Questo divario tra l'unicità a livello di macchina e la somiglianza percepita dall'uomo è il problema fondamentale che l'hashing percettivo risolve. È la tecnologia alla base di ogni moderno pulitore di foto duplicate e capire come funziona rivela perché alcuni pulitori sono notevolmente più accurati di altri.
5 livelli di rilevamento della somiglianza delle foto
La somiglianza delle foto opera su uno spettro. I moderni sistemi di rilevamento utilizzano più tecniche contemporaneamente, ciascuna ottimizzata per un livello diverso:
| Livello | Metodo di rilevamento | Cosa cattura | Velocità | Precisione |
|---|---|---|---|---|
| 1. Byte identico | Hash crittografico (MD5/SHA-256) | Copie di file esatte, duplicati AirDrop | Più veloce | 100% (ma ristretto) |
| 2. Pixel identici | Hash medio (aHash) | Versioni risalvate o ricodificate della stessa immagine | Molto veloce | 85% |
| 3. Visivamente simile | Hash percettivo (pHash/dHash) | Versioni ritagliate, filtrate o leggermente ruotate | Veloce | 92% |
| 4. Semanticamente simile | Incorporamenti neurali (CNN/Vision Transformer) | Stessa scena da diverse angolazioni, sequenze a raffica | Moderato | 97% |
| 5. Concettualmente correlato | Modelli multimodali in stile CLIP | Foto diverse dello stesso soggetto o tema | Lento | Dipendente dal contesto |
Perché i checksum MD5 mancano l'80% dei duplicati visivi
Gli hash crittografici come MD5 e SHA-256 sono stati progettati per la verifica dell'integrità dei dati, non per la somiglianza visiva. Producono un digest di lunghezza fissa in cui la modifica di un singolo bit nell'input produce un hash completamente diverso. Ciò significa:
- Risalvare un JPEG a un livello di qualità diverso → hash completamente nuovo
- Conversione da HEIC a JPEG → hash completamente nuovo
- Ritagliare 2 pixel dal bordo → hash completamente nuovo
- Aggiunta di un filtro Instagram → hash completamente nuovo
- Screenshot della stessa foto → hash completamente nuovo
Nei rullini fotografici del mondo reale, solo il 15-20% circa dei duplicati sono copie esatte a livello di byte (in genere da trasferimenti AirDrop o errori di sincronizzazione cloud). Il restante 80% sono duplicati visivi che richiedono un'analisi percettiva.
Come funziona l'hashing percettivo (pHash e dHash)
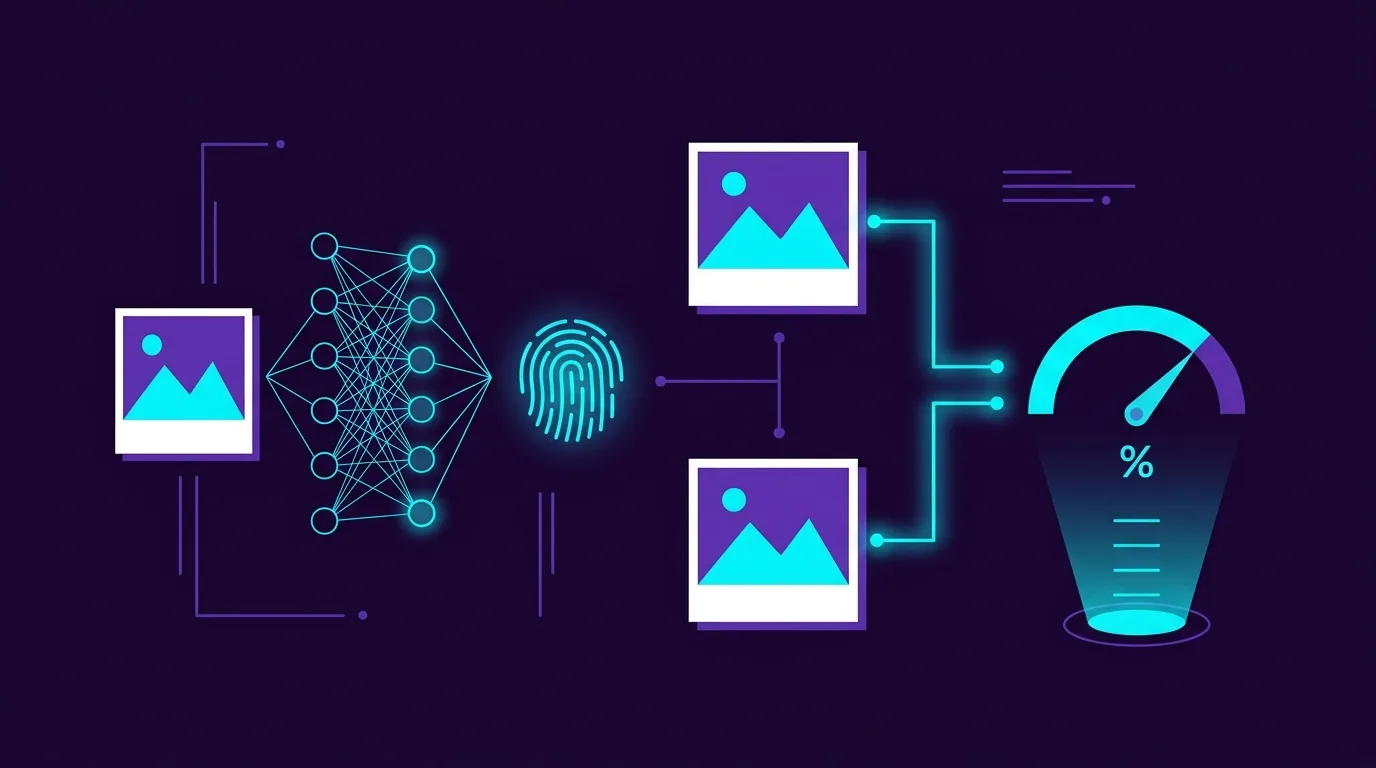
L'hashing percettivo genera un'impronta compatta che cattura la struttura visiva di un'immagine piuttosto che il suo contenuto in byte non elaborato. L'algoritmo segue una pipeline generale:
- Ridimensiona su una piccola griglia: l'immagine viene ridotta a una risoluzione ridotta (in genere 8×8 o 32×32 pixel), distruggendo i dettagli più fini ma preservando la struttura complessiva della luminanza.
- Converti in scala di grigi: le informazioni sul colore vengono scartate. La somiglianza percettiva riguarda principalmente la struttura, non la tonalità: una foto con un filtro caldo e una con un filtro freddo dovrebbero comunque corrispondere.
- Calcola il gradiente o la media: per dHash (hash della differenza), ogni pixel viene confrontato con il suo vicino destro. Per aHash (hash medio), ogni pixel viene confrontato con la luminanza media della griglia. Ogni confronto produce un singolo bit: più chiaro = 1, più scuro = 0.
- Produci impronta digitale binaria: il risultato è una stringa binaria a 64 bit (8×8) o 1024 bit (32×32): l'hash percettivo.
- Confronta utilizzando la distanza di Hamming: due immagini vengono confrontate contando quanti bit differiscono tra i loro hash. Una distanza di Hamming pari a 0 = struttura identica. Distanza ≤ 5 (su 64) = visivamente quasi identico. Distanza ≤ 10 = probabilmente simile.
Perché pHash funziona con foto filtrate
Poiché l'algoritmo scarta colore e dettagli fini nei passaggi 1-2, una versione di una foto filtrata da Instagram produce quasi lo stesso hash percettivo dell'originale. La struttura della luminanza su larga scala (cielo luminoso in alto, terreno scuro in basso) rimane identica indipendentemente dalla gradazione del colore.
SSIM: misurare ciò che vede effettivamente l'occhio umano
L'indice di somiglianza strutturale (SSIM), sviluppato da Wang et al. nel 2004, va oltre l'hashing binario. Calcola un punteggio di somiglianza continuo (da 0,0 a 1,0) basato su tre componenti che rispecchiano la percezione visiva umana:
- Confronto luminanza: i livelli medi di luminosità sono simili? (Compensa le differenze di esposizione)
- Confronto contrasto: le immagini hanno una gamma dinamica simile?
- Confronto delle strutture: i modelli spaziali delle regioni chiare e scure corrispondono?
Un punteggio SSIM superiore a 0,92 indica in genere che due immagini sono percettivamente indistinguibili per la maggior parte degli spettatori. I moderni strumenti di pulizia delle foto utilizzano questa soglia per contrassegnare automaticamente i quasi duplicati preservando composizioni realmente diverse.
Incorporamenti neurali: la frontiera del deep learning
L'hashing percettivo lotta con la somiglianza semantica: foto della stessa scena scattate da posizioni diverse o sequenze a raffica in cui il soggetto si muoveva in modo significativo tra i fotogrammi. In questi casi, le reti neurali sul dispositivo (modelli convoluzionali o Vision Transformer) estraggono vettori di incorporamento ad alta dimensione.
Ecco come funziona: la rete neurale elabora ogni foto e restituisce un vettore float a 512 dimensioni: essenzialmente 512 numeri che codificano il contenuto semantico dell'immagine. Le foto dello stesso tramonto, scattate a distanza di pochi secondi da diverse angolazioni, producono vettori di incorporamento geometricamente vicini in questo spazio a 512 dimensioni.
La somiglianza viene quindi misurata utilizzando la somiglianza coseno: il coseno dell'angolo tra due vettori. Una somiglianza coseno di 1.0 = contenuto semantico identico. Una soglia di 0,85+ rileva sequenze burst, composizioni quasi identiche e sottili variazioni che il solo hashing percettivo non vedrebbe.
Elaborazione su dispositivo o cloud: la dimensione della privacy
L'esecuzione di modelli di incorporamento neurale richiede una notevole potenza di calcolo. Alcune app per la pulizia delle foto caricano le tue immagini su GPU cloud per l'analisi: un enorme rischio per la privacy. I moderni dispositivi Apple includono il Neural Engine (16 core su A17 Pro, 5 TOPS sulla serie M), in grado di eseguire modelli di visione CoreML interamente sul dispositivo. Ciò significa che è possibile calcolare incorporamenti a 512 dimensioni per 10.000 foto in meno di 3 minuti senza che alcun dato lasci il dispositivo.
| Approccio all'elaborazione | Velocità (10K foto) | Privacy | Precisione |
|---|---|---|---|
| GPU cloud (NVIDIA A100) | 30 secondi | Foto caricate su server esterni | Massimo (modelli più grandi) |
| Motore neurale sul dispositivo | 2-4 minuti | 100% locale, trasmissione di rete zero | Eccellente (modelli CoreML ottimizzati) |
| Solo CPU sul dispositivo | 15-25 minuti | 100% locale | Buono (complessità del modello limitata) |
Guarda il rilevamento dei duplicati neurali in azione
Swipe Photo Cleaner (Wipe AI) combina l'hashing percettivo per un rapido filtraggio iniziale con incorporamenti neurali CoreML sul dispositivo per un raggruppamento semantico profondo. Il risultato: sequenze a raffica, copie filtrate e composizioni quasi identiche vengono automaticamente raggruppate con la foto più nitida evidenziata, il tutto elaborato localmente sul Neural Engine del tuo dispositivo senza caricare un singolo byte nel cloud.